

 Passages autonomes
Chaque section répond à une question, nomme son sujet dès la première phrase et se comprend sans le paragraphe qui précède.
Une réponse générée cite quelques sources. Ce service travaille les pages qui devraient en faire partie.
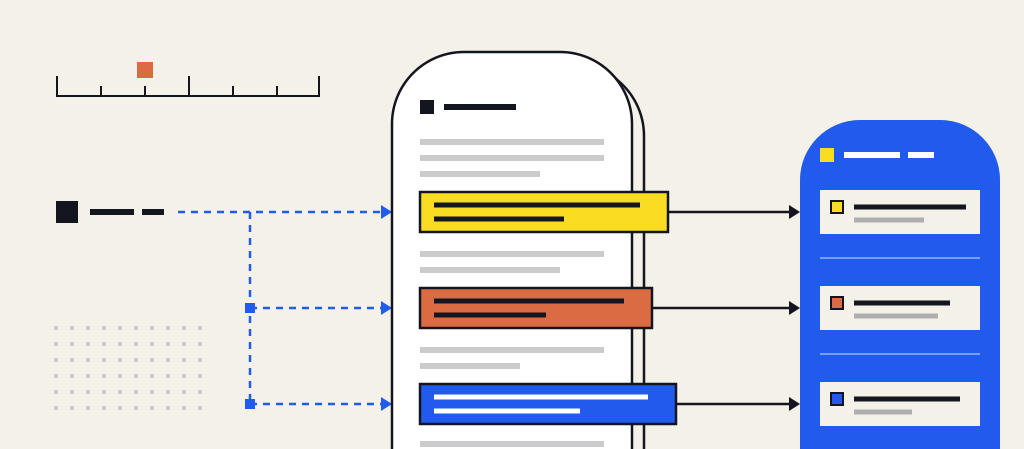
Il porte sur vos pages, une par une. Nous partons d’un lot que vous désignez — les pages qui devraient répondre aux questions de vos acheteurs — et nous les reconstruisons pour qu’un système de récupération puisse en extraire un passage qui tient seul.
Le mécanisme est documenté pour Google : les AI Overviews et l’AI Mode peuvent lancer plusieurs recherches liées à partir d’une même question — le query fan-out — puis s’appuyer sur les pages trouvées. Google précise qu’il n’existe aucune exigence technique supplémentaire : une page doit être indexée et éligible à un extrait. Le reste se joue dans ce que la page dit, et dans la façon dont elle le dit.
À notre connaissance, aucun éditeur ne publie le détail de ses critères de sélection. Ce que nous faisons relève donc d’une méthode, pas d’une recette : relever ce qui est cité aujourd’hui, formuler une hypothèse par page, corriger, relever à nouveau.
Cinq objets de travail, sur chaque page du lot. Les trois premiers concernent le texte, les deux derniers la façon de vérifier qu’on n’a pas travaillé pour rien.
Passages autonomes Chaque section répond à une question, nomme son sujet dès la première phrase et se comprend sans le paragraphe qui précède.
 Entités nommées
Produits, normes, organismes, dates : écrits en toutes lettres, de la même façon partout, et déclarés en JSON-LD quand un type schema.org existe.
 Apport d’information
Ce que la page ajoute à ce qui circule déjà : un relevé, une donnée datée, une procédure. Sans cela, nous pensons qu’aucune réécriture ne suffit.
 Sous-questions
Les requêtes dérivées d’une question ne sont pas publiées. Nous en dressons une liste d’hypothèses et vérifions quelle page répond à chacune.
 Relevé avant et après
Le même corpus de prompts, interrogé avant puis après les corrections, sur les mêmes moteurs.
Le lot est borné dès le départ. C’est ce qui permet de comparer un avant et un après sur les mêmes pages.
Vingt à quarante pages, désignées avec vous. Au-delà, le travail devient un chantier de production et relève du content engineering.
Pour chaque page, les prompts auxquels elle devrait répondre, interrogés sur les moteurs retenus. Nous notons qui est cité, et quel passage est repris.
Passages qui ne tiennent pas seuls, entités implicites, sous-questions sans réponse, et ce que les sources citées apportent que la page n’a pas.
Les passages sont réécrits dans votre CMS ou dans un document de révision, selon vos droits d’édition. Le JSON-LD part en ticket, avec le code.
Même corpus, mêmes moteurs, une fois les pages réindexées. Chaque prompt est interrogé plusieurs fois : une réponse isolée ne prouve rien.
Six livrables :
 Fiche de diagnostic par page
un document par URL : passages défaillants, entités manquantes, sous-questions non couvertes.
Passages réécrits dans votre CMS ou en document de révision, ancien et nouveau texte côte à côte.
Tickets de balisage le JSON-LD à intégrer, un ticket par gabarit, testé sur une URL d’exemple.
 Table des entités
un tableur : la forme retenue pour chaque nom, et les pages où elle doit figurer.
 Corpus de prompts
la liste des questions suivies, en CSV, réutilisable sans nous.
Relevé avant et après les réponses brutes, horodatées, et le tableau qui les compare.
Et maintenant
Vous recevez un premier avis écrit et le prix du diagnostic.
4,9/5 sur 34 avis Google. Réponse écrite, sans relance commerciale. Vos données ne servent qu’à vous répondre.