

 Accès des robots
robots.txt, pare-feu, CDN, limitation de débit : ce que chaque robot reçoit réellement, lu dans les journaux.
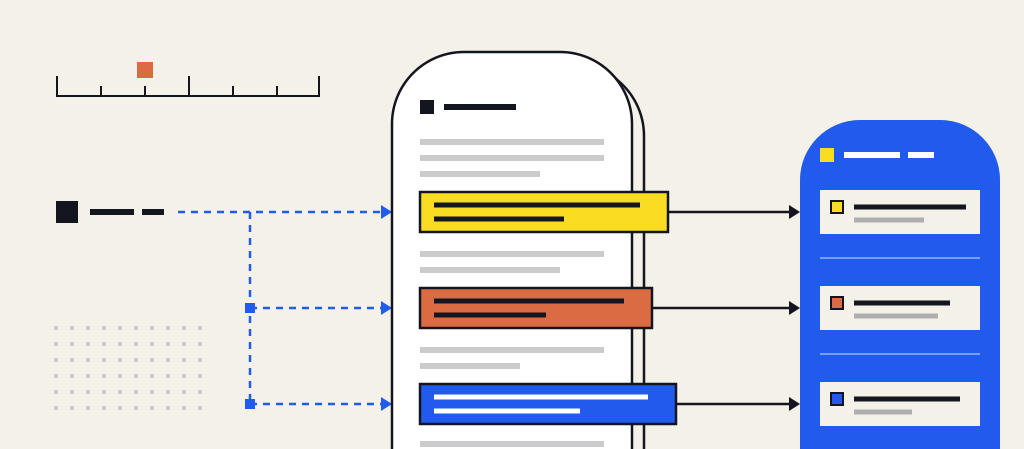
Ce qu’un robot ne peut ni atteindre ni lire n’existe pour aucun moteur.
Ce service vérifie, pièces à l’appui, ce que les robots obtiennent de votre site : quelles URL ils demandent, quel code de réponse ils reçoivent, quel HTML ils lisent. Il se termine par des tickets recettés, pas par un rapport.
Le périmètre s’est élargi. À Googlebot et Bingbot s’ajoutent les robots des éditeurs de modèles, chacun avec son rôle. Chez OpenAI, OAI-SearchBot alimente la recherche de ChatGPT, GPTBot collecte pour l’entraînement, ChatGPT-User agit à la demande d’un utilisateur, et chaque réglage est indépendant des autres. Anthropic et Perplexity documentent une séparation comparable. Bloquer « les robots d’IA » d’un seul geste, c’est prendre le risque de fermer la recherche en voulant fermer l’entraînement.
Sur le rendu, un point n’est pas documenté : ni la page d’OpenAI ni celle d’Anthropic ne disent si leurs robots exécutent JavaScript. Google l’exécute, en différé, et recommande malgré cela le rendu côté serveur, au motif que tous les robots ne savent pas le faire. Nous travaillons avec l’hypothèse prudente : ce qui n’est pas dans le HTML initial est tenu pour absent.
Cinq contrôles, menés sur vos gabarits et vérifiés dans vos journaux serveur plutôt que déduits de la configuration.
Accès des robots robots.txt, pare-feu, CDN, limitation de débit : ce que chaque robot reçoit réellement, lu dans les journaux.
 Rendu
HTML initial contre DOM rendu, gabarit par gabarit. Contenu, liens, title, canonical, JSON-LD : tout ce qui dépend de JavaScript est listé.
 Indexation
Codes de réponse, redirections, canoniques, noindex, sitemaps. Les URL que vous voulez voir indexées, celles qui le sont, et l’écart.
 Données structurées
JSON-LD valide, conforme au contenu visible, limité aux types que la page justifie. Google n’exige aucun balisage particulier pour ses fonctions d’IA.
 Performance et maillage
LCP, INP et CLS sur données de terrain — pour l’INP, web.dev place le seuil « bon » à 200 ms au 75ᵉ centile. Profondeur de clic des pages qui comptent.
L’accès d’abord, parce que tout le reste en dépend. La recette en production clôt le travail ; sans elle, un ticket fermé ne prouve rien.
Un crawl complet ou échantillonné selon la taille du site, un export de Search Console, et au moins trente jours de journaux serveur.
Quels robots passent, sur quelles URL, avec quels codes. La RFC 9309 demande à un robot de tenir tout le site pour interdit quand le robots.txt est injoignable ou renvoie une erreur serveur : une panne de ce seul fichier suspend l’exploration.
Chaque gabarit est chargé avec et sans JavaScript. Les écarts sont documentés par des captures et des extraits de code.
Chaque anomalie reçoit une gravité, un nombre d’URL concernées et une estimation d’effort faite avec vos développeurs. Ce qui n’a pas de conséquence démontrable est écarté.
Un ticket par correction, dans votre outil. Après mise en production, nous vérifions chaque correction sur le site réel et nous la clôturons — ou non.
Six livrables :
Analyse des journaux serveur un tableur : passages par robot, par répertoire et par code de réponse, sur la période fournie.
 Rapport de parité de rendu
par gabarit : ce qui figure dans le HTML initial, ce qui n’apparaît qu’après exécution de JavaScript.
 Tickets de correction
dans Jira, Linear ou GitHub : contexte, URL d’exemple, comportement attendu, critère de recette.
Fichier robots.txt commenté la version proposée, chaque règle justifiée, robot par robot.
Plan de données structurées types retenus par gabarit, code JSON-LD d’exemple, résultat des validateurs.
 Procès-verbal de recette
la liste des corrections vérifiées en production, avec la date et la preuve.
ClaudeBot, Claude-User et Claude-SearchBot. La page ne mentionne pas l’exécution de JavaScript. Consultée le 19 novembre 2026. PerplexityBot et Perplexity-User. Consultée le 19 novembre 2026. robots.txt injoignable impose de supposer une interdiction complète, un code 4xx autorise l’exploration. Consultée le 19 novembre 2026. Et maintenant
Vous recevez un premier avis écrit et le prix du diagnostic.
4,9/5 sur 34 avis Google. Réponse écrite, sans relance commerciale. Vos données ne servent qu’à vous répondre.